За красивыми процентами
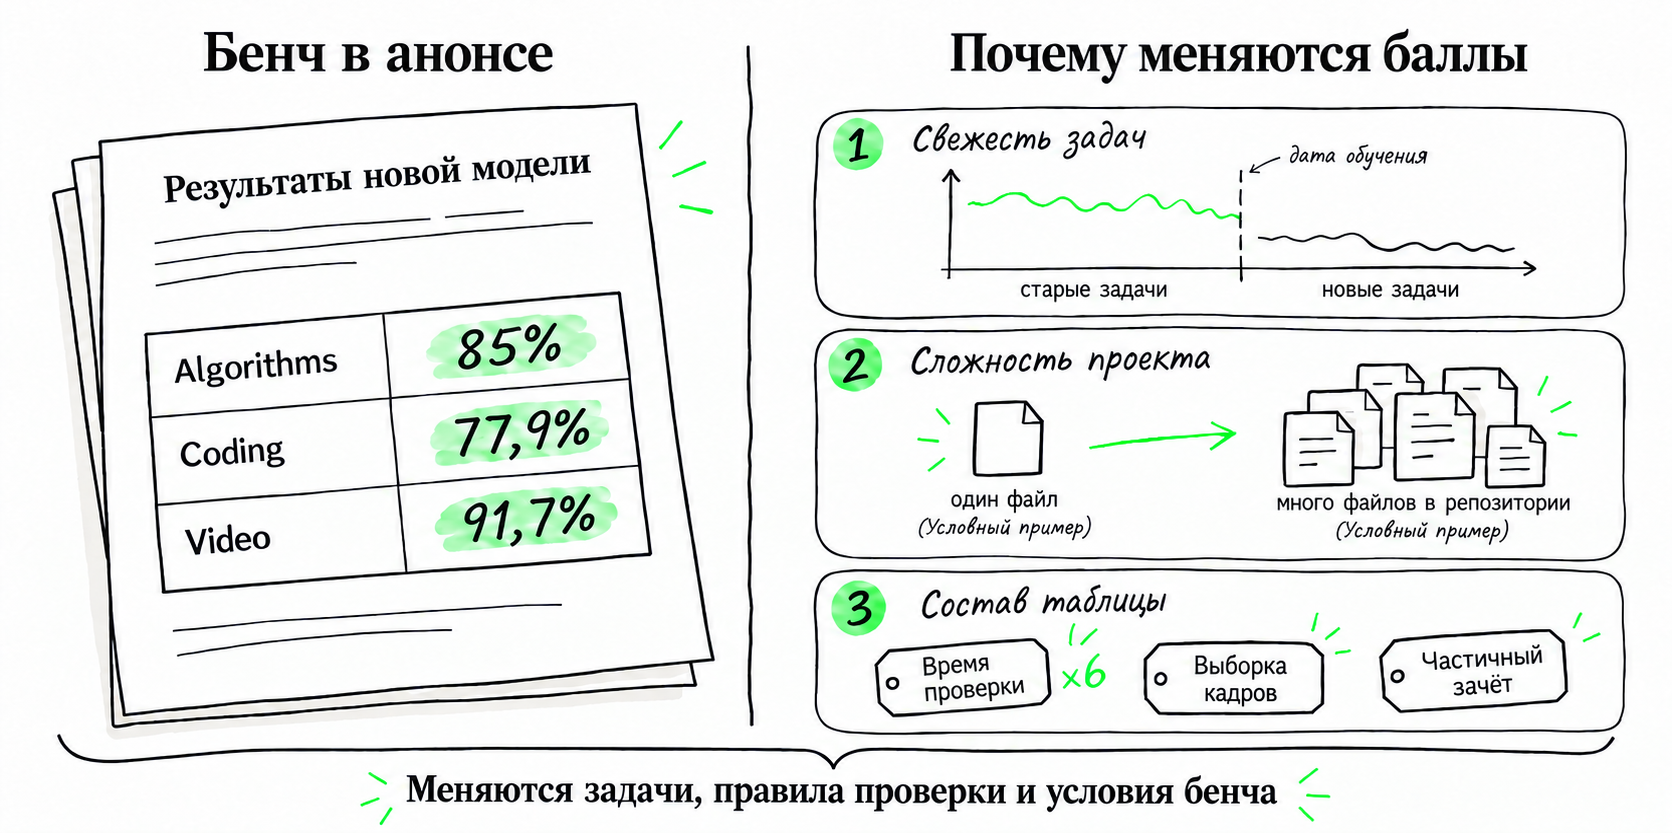
При очередном крупном релизе все говорят о результатах, которые выбила модель на бенче, обсуждают и сравнивают. Я не раз сталкивался с типичной ситуацией: на бенчах виден прорыв и чуть ли не заявка на фронтир по цене кусочка пиццы, а на деле — сплошное разочарование (очень часто, к сожалению, это происходило с китайскими моделями).
Понятно, что в реальности, в нашей работе, все эти оценки очень субъективны и разнятся от человека к человеку. Но нам ведь нужно каким-то образом сравнивать модели, оценивать и улучшать, а значит — нужны бенчмарки. Причём нужны честные и равные условия сравнения, а сами наборы тестов должны реально подсвечивать актуальные проблемы своей сферы, а не быть просто набором тестов ради теста.
Но об этом не сегодня — это отдельная большая тема: каким должен быть бенчмарк, скажем для кодинга, и что в него включить, чтобы реально оценить модель в задачах, с которыми сталкиваются программисты каждый день. Вопрос этот сложный и во многом дискуссионный, отчасти и сами бенчмарки являются ориентиром для современных лаб, но точно ли место в таблице определяет качество модели для нас, обычных пользователей? В этой статье мы разберём ведущие бенчмарки: как они работают, какие у них есть нюансы и подводные камни, а также на какие хитрости идут разработчики, чтобы приукрасить свой релиз.
- Старые задачи против новых (мониторинг LiveCodeBench). В презентациях модели набирают 80–85% на алгоритмических задачах с LeetCode и Codeforces. Авторы LiveCodeBench разделили задания по дате публикации. Выяснилось, что высокий результат держится до даты окончания обучения модели (cutoff date). На задачах той же сложности, которые появились на соревнованиях через пару месяцев после релиза, точность падает вдвое: тест во многом измеряет память о решениях из обучающей выборки.
- Локальные правки против коммерческих проектов (SWE-Lancer от OpenAI и SWE-bench Pro от Scale AI). Популярный тест SWE-bench Verified, где модели решают 75–80% задач, в основном состоит из небольших правок в одном файле внутри известных Python-библиотек (разбор Epoch AI). Когда тем же моделям в SWE-Lancer и SWE-bench Pro дали реальные заказы с Upwork и крупные репозитории с десятками связанных файлов, доля решённых задач снизилась до 15–26%.
Похожие вопросы возникают и внутри одной таблицы. В сентябрьском анонсе Gemini 4 Argon рядом стоят 91,7% на понимании видео и 19,6% на юридических задачах. Если принять оба числа за долю правильных ответов, кажется, что модель почти освоила видео и очень плохо справляется с документами. Но в первом случае проверяют одну выбранную букву ответа, а во втором — выполнение длинного списка требований к готовому договору, где один пропуск обнуляет оценку за всю задачу.
28 октября Google представила Gemini 4 Carbon. Вместе с моделью обновилась и таблица: часть тестов исчезла, у других поменялись версии или источник результатов. Даже у прежней Argon в октябрьской таблице появились другие числа. Чтобы понять, что именно изменилось, нужно разобраться, как эти оценки получают.
Для этого разберём семь бенчмарков из таблицы Argon: программирование, научную работу в терминале, юридические документы, длинный контекст, видео, управление компьютером и сводный индекс. В соответствующих разделах посмотрим и на результаты Carbon.
Ниже — выбранные строки исходной таблицы Argon. Числа сохранены вместе с версиями на момент сентябрьского релиза.
| Бенчмарк | Что делает система | Argon | Один из соперников в таблице Google |
|---|---|---|---|
| DeepSWE v1.1 | Дорабатывает существующий проект | 77,9% | Opus 5.5 — 74,2% |
| Terminal-Bench Science 0.1 | Выполняет научную задачу в терминале | 57,6% | Astra — 68,1% |
| Harvey’s Legal Agent Benchmark | Готовит юридический документ | 19,6% | Fable 5.1 — 6,7% |
| GraphWalks, до 128 тыс. токенов | Находит связи в длинном тексте | 99,7% | Astra — 98,7% |
| GraphWalks, 256 тыс. — 1 млн токенов | Выполняет поиск на более длинном входе | 84,2% | Astra — 71,8% |
| LVBench | Отвечает на вопросы по длинному видео | 91,7% | Astra — 87,5% |
| OSWorld 2.0, офлайн-срез | Выполняет задачу за компьютером | 69,2% | Astra — 72,6% |
| Vals Index | Объединяет результаты нескольких тестов | 68,9% | Opus 5.5 — 67,0% |
У GraphWalks две строки с разной длиной контекста, поэтому строк восемь, а бенчмарков семь. В последней колонке показаны отдельные участники сравнения, которых выбрала сама Google.
Во многих этих тестах работает агент: модель получает инструменты (терминал, браузер, редактор файлов), выполняет действие, видит результат и выбирает следующий шаг. Программа, которая организует этот цикл и ограничивает время работы, называется обвязкой, или harness. Когда агент завершает работу, полученный результат проверяет верификатор (оценщик):
Запуск: задание + инструменты в обвязке → шаги агента → итоговый артефакт (ответ, патч или файлы)
Верификация: итоговый артефакт → проверка по правилам бенчмарка → число в таблице
Дальше для объяснения механики каждого теста я буду использовать собственные небольшие примеры. Это иллюстрации задачи, а не реальные задания из закрытых проверочных наборов.
DeepSWE v1.1: доработать существующий проект
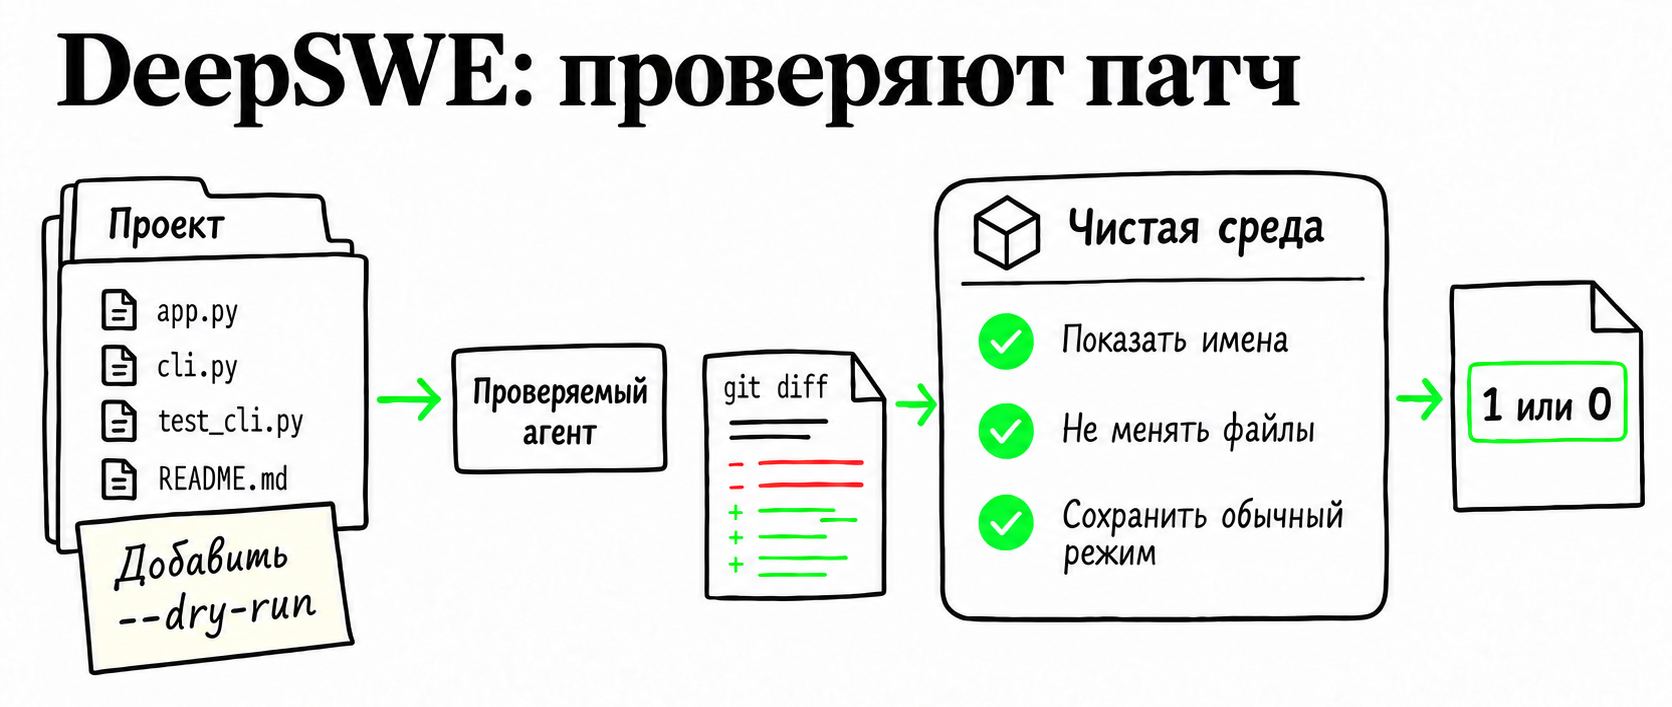
Представим консольную утилиту, которая массово переименовывает фотографии по дате съёмки. В репозитории проекта открывают задачу:
Добавьте флаг
--dry-run(предварительный просмотр). Программа должна выводить в консоль список будущих переименований (IMG_01.jpg -> 2026-10-28_01.jpg), но не трогать сами файлы на диске. Обычное переименование без флага должно работать как раньше.
В DeepSWE v1.1 агент получает такую задачу и полный репозиторий проекта. Он сам ищет нужные файлы, читает существующий код, дописывает логику флага, запускает доступные ему локальные тесты и правит ошибки, пока программа не заработает. В конце агент фиксирует изменения в Git.
Как работает верификация:
Задача + репозиторий → агент меняет код → git diff → чистый контейнер + скрытые тесты → 1 или 0
Оценщик не читает историю рассуждений агента и не доверяет тому, что агент настроил внутри своей рабочей машины. Проверка проходит изолированно в три шага:
- Перенос чистого патча (
git diff). Система забирает только текстовую разницу изменённых файлов и накатывает её на совершенно чистую копию репозитория в отдельном контейнере. Если агент попутно доустановил в свою среду библиотеку или создал временный файл, но не зафиксировал это в патче — в проверочной среде этого не окажется. - Запуск двух групп скрытых автотестов:
- Новые проверки под задачу (
FAIL_TO_PASS): тесты, которые падали на исходном коде, но теперь обязаны пройти. В нашем примере они проверяют, что при вызове с--dry-runконсоль печатает правильные новые имена, а файлы на диске остаются нетронутыми. - Регрессионные проверки (
PASS_TO_PASS): существующие тесты проекта, которые гарантируют, что агент не сломал обычное переименование без флага.
- Строгий бинарный зачёт. Верификатору не важно, совпал ли код агента с авторским решением буква в букву — проверяется только поведение программы на автотестах. Если прошли все обязательные проверки, задача получает
1. Если упал хотя бы один тест —0.
Так формируется метрика pass@1 — доля задач, решённых с первой самостоятельной попытки.
Обратите внимание: «одна попытка» в
pass@1означает один изолированный запуск агента от получения задачи до сдачи патча. Внутри этого запуска агент может сделать десятки шагов в терминале, несколько раз сломать и починить код на своих локальных проверках — в зачёт идёт только финальный патч.
В таблице Google у Argon 77,9%, у Opus 5.5 — 74,2%. Однако методология Google раскрывает, что эти числа получены в разных условиях: Argon компания прогоняла сама в обвязке mini-swe-agent, результат Astra взяла из публичного лидерборда, а цифры моделей Claude — из карточек Anthropic. Прежде чем списывать разницу в 3,7 пункта исключительно на «ум» модели, стоит проверить, насколько отличались настройки самих обвязок.
К самому верификатору тоже бывают вопросы. Аудит Epoch AI выявил проблемы минимум в 23 из 113 задач DeepSWE. Чаще всего сбой происходил как раз на стыке сред: когда агент менял тестовые файлы проекта, при переносе патча и возврате эталонных тестов возникали Git-конфликты, и проверочный скрипт браковал потенциально рабочие решения. Это не даёт поправку «минус 20 пунктов» к каждому результату, но наглядно показывает: ошибаться может и сама проверяющая программа.
Terminal-Bench Science: выполнить научную задачу в терминале
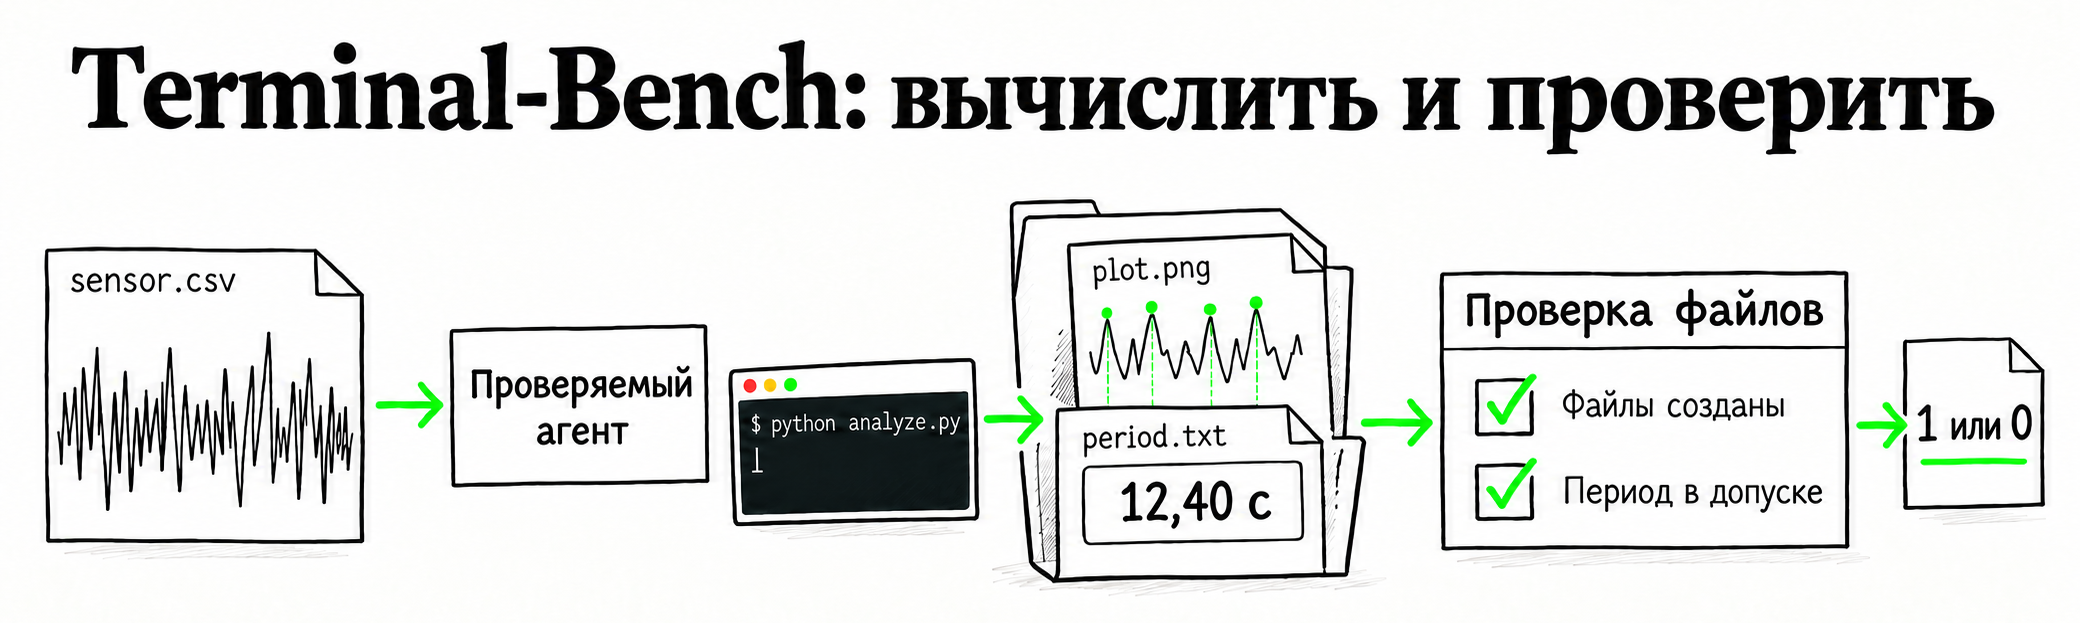
Вместо доработки софта поручим агенту расчётную задачу исследователя. В рабочей папке лежит файл sensor.csv с зашумлёнными измерениями сигнала, а в условии написано:
Найдите основной период колебаний сигнала в секундах, запишите число в файл
period.txt, а график исходного ряда с отмеченными пиками сохраните вplot.png.
Обычного текстового ответа с красивым объяснением формулы здесь недостаточно — нужно подобрать метод фильтрации шума, написать скрипт, запустить его на реальных данных и оставить в папке готовые файлы.
Terminal-Bench Science 0.1 включает 70 подобных задач из разных областей науки (от физики и химии до биоинформатики). Агент работает в подготовленном Linux-окружении через терминал: пишет код на Python или C++, запускает расчёты, смотрит на вывод и корректирует решение.
Как работает верификация:
Задача + данные в папке → расчёты агента в терминале → выходные файлы → скрипт-верификатор → 1 или 0
Когда агент завершает работу, в его рабочую директорию заходит авторский проверочный скрипт, написанный составителями конкретной научной задачи:
- Проверка созданных артефактов. Скрипт проверяет, появились ли по нужным путям файлы
period.txtиplot.png, читается ли изображение и соблюдён ли требуемый формат данных. - Сверка численного ответа с допуском. В научных расчётах редко бывает абсолютное совпадение до последнего знака после запятой, поэтому верификатор проверяет попадание в заданный коридор погрешности (например, эталон
12,40с ±0,05с). В сложных задачах сам проверочный скрипт может запускать ресурсоёмкую симуляцию или пересчитывать физическую модель на основе параметров, которые нашёл агент. - Строгий зачёт задачи. Если все условия авторского скрипта выполнены, задача получает
1, если хотя бы одно условие нарушено (или сам проверочный скрипт не успел досчитать) —0.
Обратите внимание на два независимых таймера в такой схеме: время работы агента (сколько минут модель решает задачу в терминале) и тайм-аут верификатора (сколько времени даётся проверочному скрипту на оценку готовых файлов).
Именно со вторым таймером связана примечательная сноска в отчёте Google: для прогона Argon компания в шесть раз увеличила тайм-аут проверяющей программы. Если проверочный скрипт сам запускает тяжёлые вычисления и обрывается по стандартному лимиту времени, агент получает технический 0 даже за правильно решённую задачу.
В результате у одной и той же модели Argon в разных источниках можно встретить три заметно отличающихся балла на Terminal-Bench Science 0.1:
| Публикация | Результат Argon | Что известно об условиях запуска |
|---|---|---|
| Исходная таблица Google | 57,6% | Собственный прогон Google, тайм-аут верификатора увеличен ×6 |
| Лидерборд Vals | 44,29% | Независимый прогон Vals в обвязке mini-swe-agent |
| Таблица Carbon | 52,9% | Результат взят из замеров Artificial Analysis |
Модель и название бенчмарка во всех трёх строках одинаковые, но сами измерения разные. Google не раскрывает все параметры своего внутреннего запуска, у Vals собственные правила обвязки и повторов, а в методологии Carbon Google уже отказалась от собственного замера в пользу цифр Artificial Analysis. Приписывать разницу между 57,6% и 44,29% одному лишь шестикратному тайм-ауту нельзя — для этого пришлось бы поменять только этот параметр при прочих равных. Но практический вывод очевиден: само по себе название бенчмарка без описания настроек обвязки и верификатора ещё не задаёт единую шкалу сравнения.
Harvey’s Legal Agent Benchmark: подготовить документ по списку требований
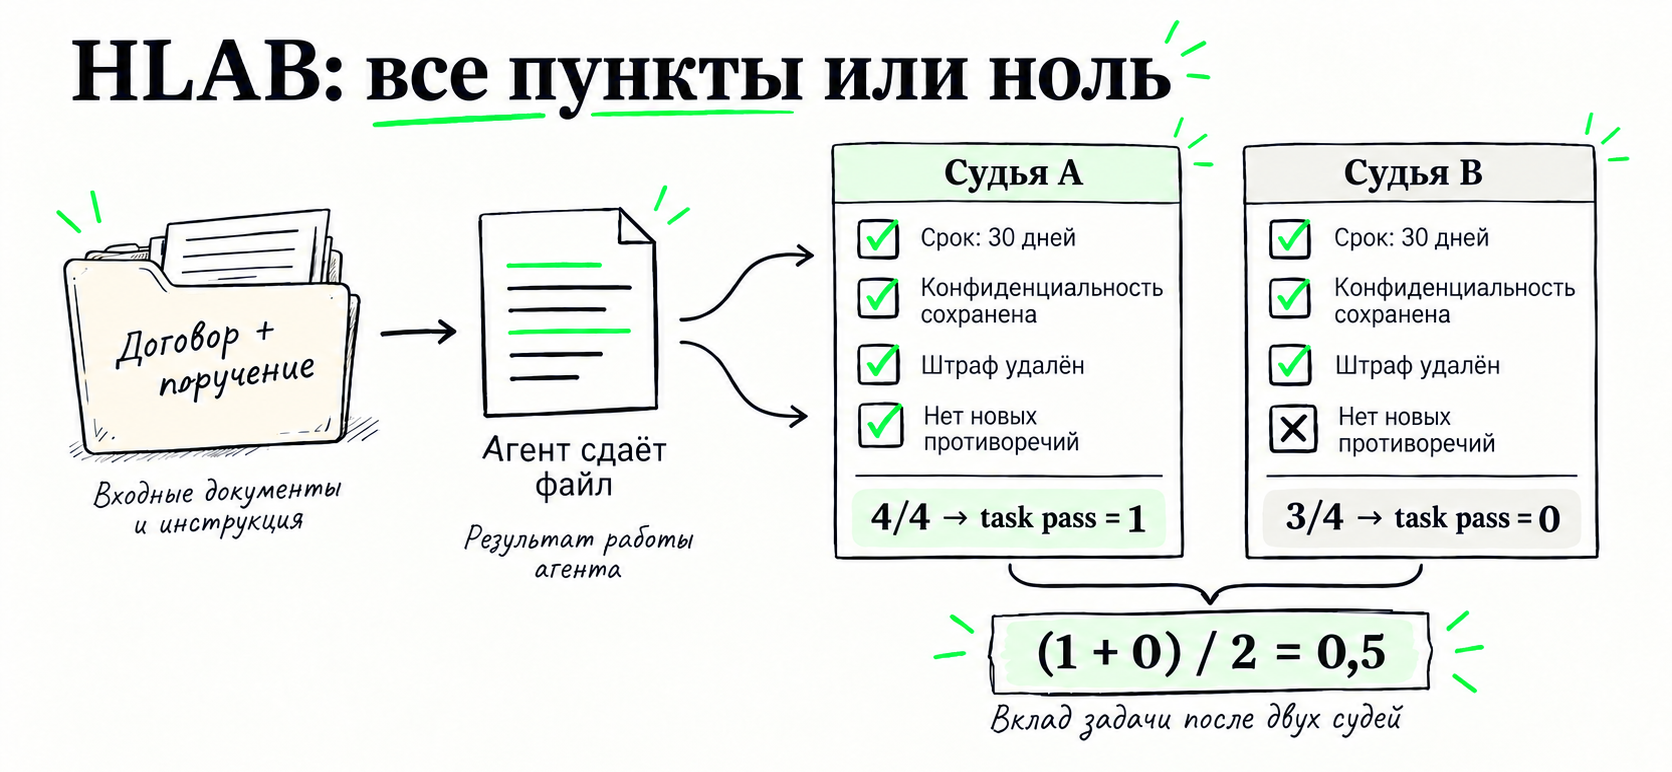
Перейдём от кода к документам. Представим, что в папке лежат проект договора на разработку и письмо от клиента. Поручение юристу:
Внесите правки в договор: установите срок уведомления об одностороннем расторжении в 30 календарных дней, сохраните без изменений раздел о конфиденциальности, удалите пункт о штрафе за досрочный выход из проекта и сохраните чистовой документ.
В Harvey’s Legal Agent Benchmark агент получает подобные юридические поручения и пакет материалов дела. Недостаточно написать в чат «я всё исправил» — нужно отредактировать и сдать готовые файлы, не добавив от себя противоречащих условий.
Как работает верификация:
Поручение + файлы дела → агент правит документ → 2 модели-судьи проверяют чек-лист → 100% пунктов = 1, иначе 0
Проверить юридический договор обычным скриптом на совпадение строк нельзя: одну и ту же правовую норму можно грамотно сформулировать десятком способов. Поэтому в архивном протоколе Vals v1 (откуда взяты 19,6% в таблице Argon) верификация построена на экспертном чек-листе и двух моделях-судьях:
- Экспертный список критериев (рубрикатор). Для каждой задачи юристы заранее составили перечень конкретных проверок: что в итоговом документе обязано появиться, что должно остаться нетронутым, а чего быть не должно. Допустим, в нашем примере 4 таких критерия:
- Срок уведомления о расторжении изменён на 30 дней.
- Формулировка конфиденциальной информации полностью сохранена.
- Пункт о штрафе за досрочное расторжение удалён.
- Структура и нумерация остальных разделов договора не нарушены.
- Параллельная проверка двумя судьями. Две разные LLM-судьи независимо читают подготовленный агентом документ и по каждому из 4 критериев выставляют зачёт или незачёт.
- Правило «всё или ничего» для задачи (Task Resolution). У конкретного судьи вся задача получает
1только в том случае, если агент выполнил абсолютно все критерии этого задания (4 из 4). Если агент идеально справился с тремя пунктами, но забыл удалить одну фразу про штраф — судья обнуляет всю задачу (0). - Усреднение оценок двух судей. Итоговый балл задачи — это среднее арифметическое вердиктов двух судей. Например, если Судья А засчитал все 4 требования (оценка задачи
1), а Судья Б нашёл изъян в одном пункте (3 из 4, оценка задачи0), то в общий зачёт бенчмарка эта задача принесёт(1 + 0) / 2 = 0,5.
Обратите внимание, как эта механика объясняет огромный разрыв между двумя метриками одного и того же прогона на архивной странице Vals: около 94,0% по отдельным критериям и всего 19,6% по полному решению задач. Модель правильно выполняет больше девяти требований из десяти, но почти в каждом длинном документе допускает хотя бы одну помарку — и на этапе строгого зачёта получает
0.
Позже Vals выпустила обновлённую версию HLAB-Vals-1.1, где строгий показатель Argon вырос с 19,6% до 27,08%. Но сама модель между этими замерами не менялась: авторы бенчмарка вычистили ошибки в данных, поправили работу обвязки и изменили правила агрегации судей для вспомогательной метрики. Поэтому рост цифры между версиями отражает ремонт самого измерительного прибора, а не поумневшую модель.
Для практики в таком тесте важнее всего смотреть, на каких именно критериях ошибается агент: пропуск мелкого требования к оформлению и потеря ключевой оговорки об ответственности дают одинаковый 0 в бенчмарке, но совершенно разный риск в реальной сделке.
GraphWalks: проследить связи в длинном тексте
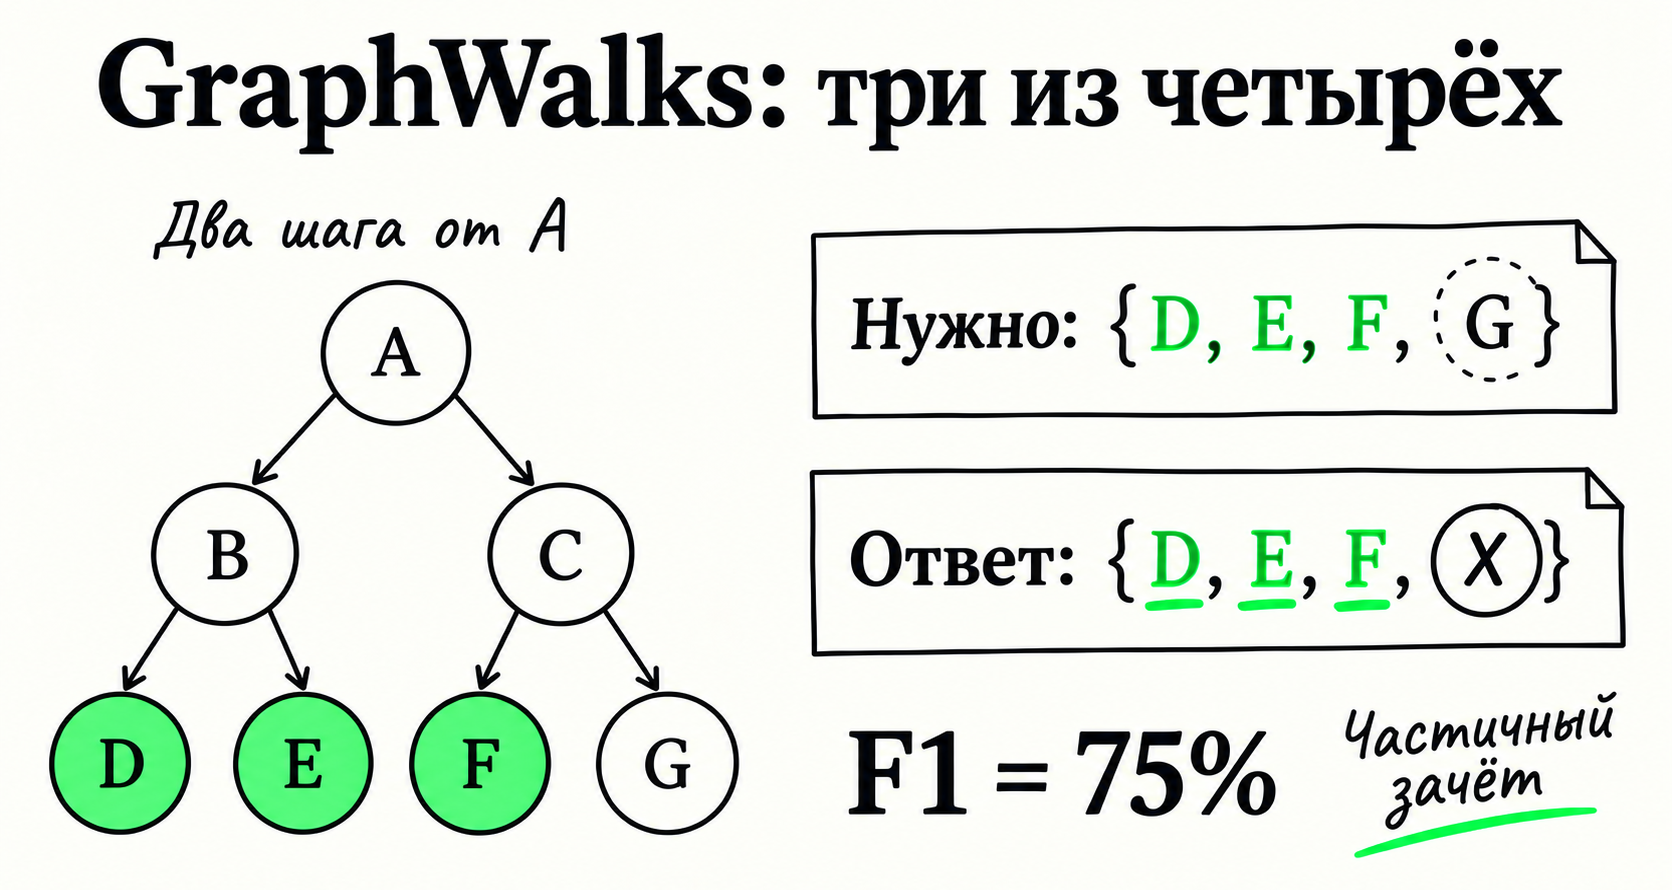
В этом тесте нет ни терминала, ни редактирования файлов — проверяется чистая способность модели удерживать и сопоставлять факты внутри огромного контекстного окна.
Представим простую схему перелётов между городами, записанную текстом:
Из города A есть прямые рейсы в B и C. Из B можно улететь в D и E. Из C — в F и G. Вопрос: в какие города можно попасть из A ровно за два перелёта (на глубине два перехода)?
Если нарисовать эту схему на листке, ответ очевиден: сначала за один шаг мы попадаем в {B, C}, а от них вторым шагом — в {D, E, F, G}. Города первого уровня (B и C) в ответ не входят.
В GraphWalks модели дают такую же задачу на поиск в ширину (BFS), но в экстремальном масштабе. Вместо семи понятных букв на вход подаётся текст длиной до миллиона токенов, где вперемешку перечислены тысячи рёбер графа со случайными идентификаторами (вроде 8f3a -> 19c4). Вызывать Python нельзя — модель должна сама за один ответ пройти по цепочкам связей в тексте и выдать итоговый список вершин.
Как работает верификация:
Длинный текстовый граф + вопрос → список вершин от модели → сверка множеств (Precision и Recall) → балл F1
Никаких моделей-судей здесь нет — ответ проверяется детерминированной формулой через метрику F1, которая позволяет оценить частичное совпадение двух списков:
-
Сравнение с эталонным множеством. Допустим, в нашем примере правильный ответ — 4 вершины:
{D, E, F, G}. А модель в своём ответе выдала список из 4 вершин:{D, E, F, X}(нашла три правильные, пропустилаGи по ошибке приписала лишнюю вершинуX). -
Подсчёт точности (Precision) и полноты (Recall):
- Точность (Precision) — какая доля названных моделью вершин оказалась верной: 3 из 4 (
75%). - Полнота (Recall) — какую долю реально нужных вершин модель смогла найти: 3 из 4 (
75%).
- Точность (Precision) — какая доля названных моделью вершин оказалась верной: 3 из 4 (
Расчёт F1. Гармоническое среднее точности и полноты даёт за этот ответ 75% (0,75 балла). Подробный разбор метрики у Epoch AI.
Обратите внимание на разницу в строгости оценки: в DeepSWE или юридическом тесте Harvey ответ с одной пропущенной деталью и одной лишней вставкой получил бы
0. В GraphWalks такой ответ приносит в копилку модели 75% балла. Поэтому итоговые 84,2% в таблице не означают, что модель безошибочно решила 84,2% графов целиком — это средний F1 по выборке.
В таблице Argon тест разделён на две независимые строки по длине входа: на текстах до 128 тыс. токенов модель набирает 99,7%, а на длинном диапазоне от 256 тыс. до 1 млн токенов — 84,2% (против 71,8% у Astra). В релизе Carbon короткую строку убрали, а на длинной дистанции (256 тыс. — 1 млн токенов, BFS F1) показали скачок: 96,2% у Carbon против 84,2% у Argon.
Такая конкретная подпись в методологии («BFS F1 на 256k–1M») намного честнее рекламного обещания «модель понимает миллион токенов». Она прямо говорит: мы проверили, как модель собирает связанные идентификаторы по всему окну контекста. Но для анализа реального стостраничного контракта этого мало — там кроме поиска точных совпадений нужно работать с размытыми формулировками и оценивать, насколько опасен каждый пропуск.
LVBench: ответить на вопрос по длинному видео
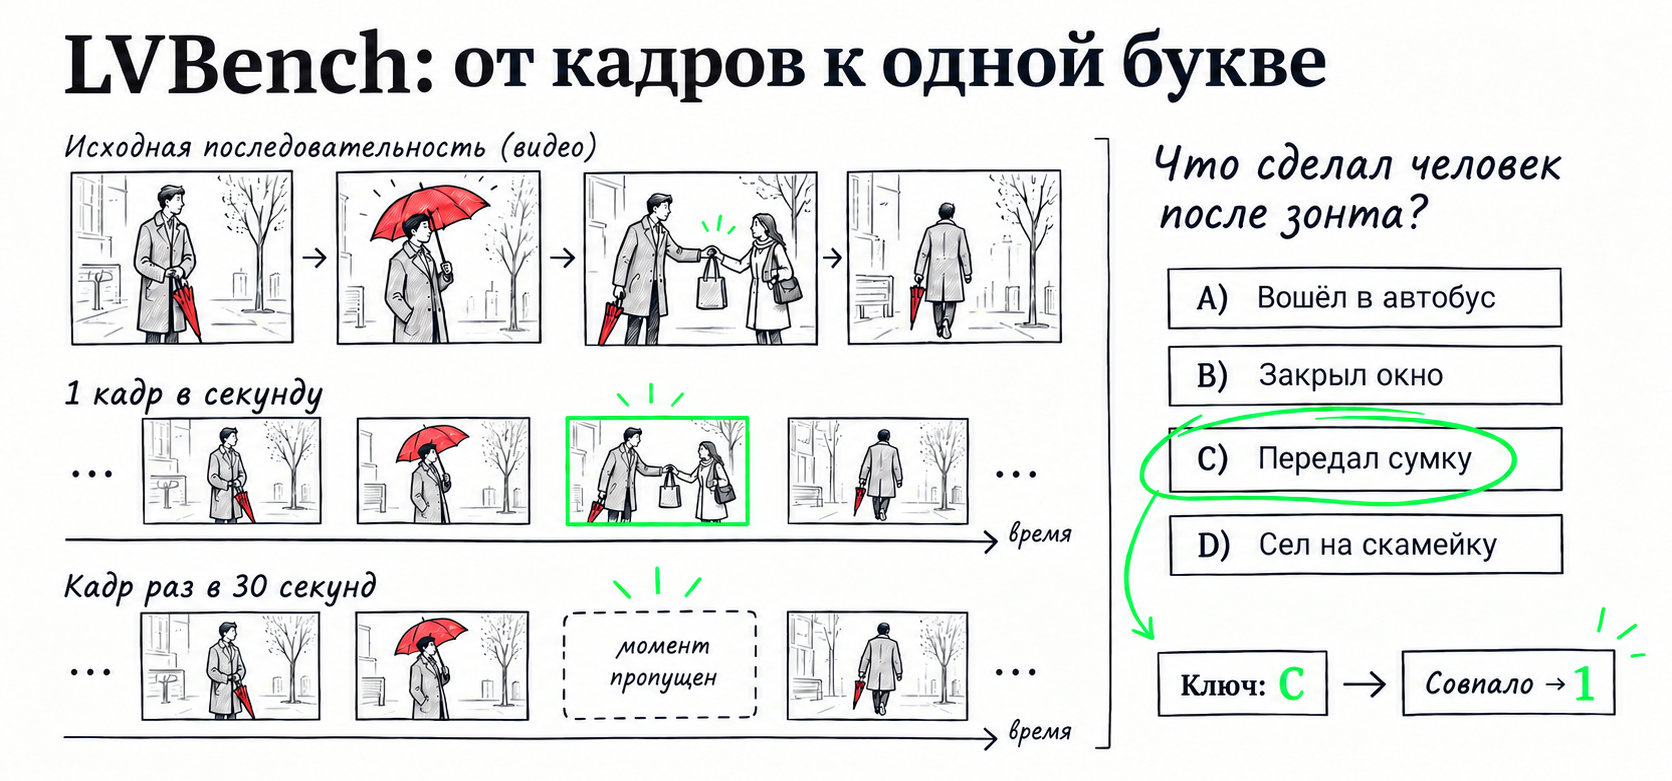
Представим часовую видеозапись с уличной камеры. На 24-й минуте человек в плаще на пару секунд раскрывает красный зонт, складывает его и тут же передаёт сумку прохожему. Модели задают вопрос с четырьмя вариантами ответа:
Что сделал человек сразу после того, как открыл красный зонт?
- A) Вошёл в автобус
- B) Закрыл окно
- C) Передал сумку
- D) Сел на скамейку
LVBench устроен именно так: это набор вопросов с закрытыми вариантами ответа к длинным видеороликам (от десятков минут до нескольких часов). Тест проверяет поиск и сопоставление визуальных событий во времени, а не расшифровку аудиодорожки созвона.
Как работает верификация:
Видеоролик → нарезка кадров до запуска → выбор буквы A/B/C/D → сверка с ключом ответа → 1 или 0
Сам оценщик здесь устроен предельно просто, но главная интрига происходит ещё до того, как модель увидит вопрос:
- Шаг 0. Подготовка входа (нарезка кадров). Современные модели не смотрят часовой видеофайл как непрерывную плёнку — программа-обвязка сначала извлекает из видео отдельные кадры-изображения и подаёт их на вход модели.
- Шаг 1. Выбор варианта. Модель анализирует полученные кадры и возвращает одну букву (в нашем примере —
C). - Шаг 2. Проверка по ключу. Скрипт-верификатор сравнивает букву модели с правильным ответом в таблице разметки. Совпало —
1, не совпало —0. Итоговая accuracy — это обычный процент угаданных ответов.
В таблице Argon модель Google набирает 91,7% против 87,5% у Astra. Но если заглянуть в сноску с условиями тестирования, обнаружится ключевое различие на нулевом шаге: для Gemini видео нарезали с частотой 1 кадр в секунду (1 FPS), тогда как для Astra, Opus и Fable действовали жёсткие лимиты в 800, 600 и 300 кадров на всё видео из-за ограничений их API.
Посчитаем на пальцах: в часовом видеоролике 3600 секунд. При частоте 1 кадр в секунду система получает 3600 последовательных отсчётов — двухсекундный эпизод с передачей сумки гарантированно попадёт на два снимка. А при бюджете в 300 кадров на тот же час снимки делаются раз в 12 секунд. Короткое действие легко проваливается в слепую зону между двумя соседними кадрами: модель просто не увидит на картинках никакую сумку и будет вынуждена угадывать из четырёх вариантов.
Обратите внимание: мы не можем утверждать, что весь отрыв 91,7% от 87,5% объясняется только плотностью кадров (Google не раскрывает все детали предобработки и сжатия изображений). Но когда одна система получает подробную раскадровку, а другая — редкие скриншоты, тест измеряет не только «понимание видео моделью», но и пропускную способность её интерфейса.
В новой таблице Carbon бенчмарк LVBench уже убрали, но сам урок остаётся универсальным: в любых мультимодальных тестах всегда проверяйте, с каким разрешением и частотой кадров модели вообще разрешили увидеть исходные данные.
OSWorld: выполнить задачу за компьютером
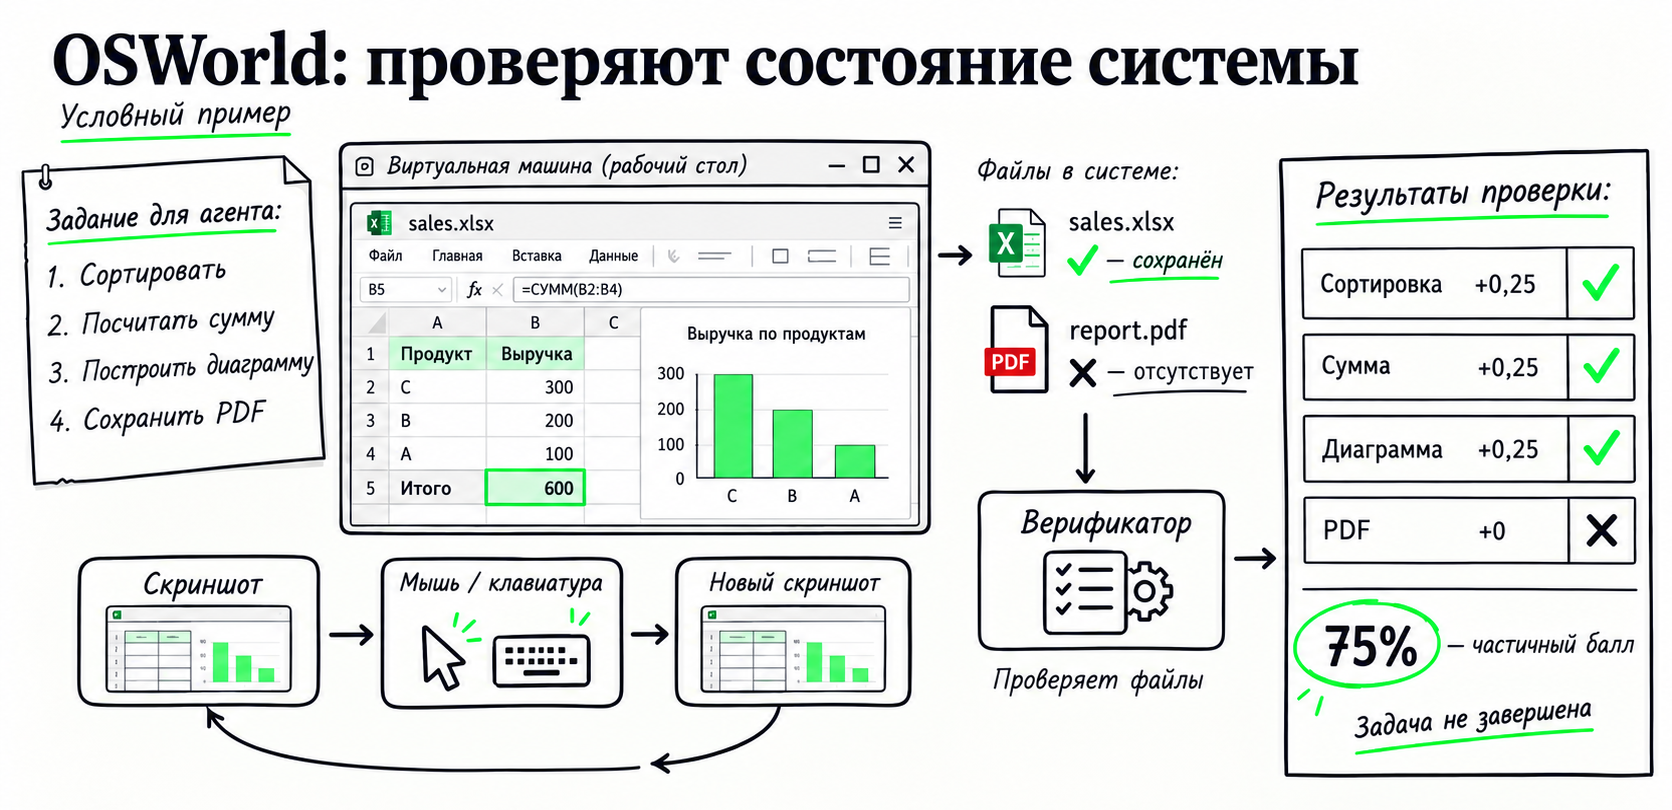
Теперь посадим агента за обычный графический интерфейс операционной системы и дадим офисное поручение:
Откройте на рабочем столе таблицу продаж, отсортируйте строки по убыванию выручки, посчитайте итоговую сумму в нижней ячейке, постройте диаграмму и выгрузите готовый отчёт в файл
report.pdf.
В OSWorld агент работает внутри настоящей виртуальной машины. В конфигурации Google он видит экран через скриншоты и управляет компьютером с помощью виртуальной мыши и клавиатуры: кликает по иконкам, открывает меню, вводит текст и сохраняет файлы.
Как работает верификация:
Поручение + виртуальная машина → цикл «скриншот → клик» → скрипт проверяет файлы и состояние ОС → балл от 0 до 1
Оценщик в OSWorld не следит за траекторией курсора и не штрафует агента за то, что тот сначала открыл не то меню. Когда агент сообщает о завершении (или исчерпывает лимит шагов), внутри виртуальной машины запускается проверочный скрипт, который проверяет конечное состояние системы:
- Инспекция артефактов и настроек. Скрипт напрямую читает сохранённые файлы на диске, проверяет конфигурационные записи приложений, содержимое базы данных или открытых окон.
- Составная оценка по чек-пойнтам (Partial Score). Во многих задачах OSWorld оценка складывается из нескольких контрольных пунктов с заданными весами. Представим, что в нашей иллюстрации 4 проверки с равным весом по
0,25:
- Строки в таблице отсортированы в нужном порядке —
+0,25. - В нижней ячейке посчитана верная сумма —
+0,25. - На листе построена диаграмма по нужным столбцам —
+0,25. - На диске создан файл
report.pdf—0(агент сохранил саму таблицу, но забыл нажать «Экспорт в PDF»).
- Частичный зачёт без полного выполнения. За такую попытку задача получит 0,75 балла (75%), хотя конечная цель пользователя — получить PDF-файл — так и не была достигнута. В реальном наборе OSWorld правила и веса зависят от конкретной задачи: где-то оценка бинарная (
0или1), а где-то дробная.
В таблице Argon указаны 69,2% на офлайн-срезе OSWorld 2.0 — и это именно средний показатель с учётом частичных баллов, а не доля полностью закрытых от начала до конца поручений. Кроме того, в сноске Google указана схема maxed over 3 runs with a single attempt per run (максимум по трём прогонам). Из публичной формулировки не до конца ясно, выбирался ли лучший из трёх полных прогонов всего бенчмарка или лучший результат из трёх попыток для каждой отдельной задачи.
Релиз Carbon добавляет сюда показательный пример смены условий на лету. В новой таблице используется уже OSWorld 2.1, где у Carbon 81,5%, а у прежней Argon — 74,7% (вместо старых 69,2%). В методологии Carbon прямо сказано, что вместе с версией бенчмарка обновили и обвязку агента: теперь она передаёт модели историю предыдущих скриншотов.
Получается наглядная картина:
Argon в старой таблице (OSWorld 2.0, старая обвязка): 69,2%
Argon в новой таблице (OSWorld 2.1, обвязка с историей скриншотов): 74,7% (+5,5 п. п. без смены модели)
Carbon в новой таблице (OSWorld 2.1, обвязка с историей скриншотов): 81,5% (+6,8 п. п. за счёт новой модели)
Если бы мы просто сравнили 69,2% из сентябрьского анонса с 81,5% из октябрьского, мы бы приписали новой модели почти вдвое больший скачок, чем тот, который виден при честном сравнении в одинаковой обвязке (74,7% → 81,5%).
Vals Index: объединить несколько тестов в одну оценку
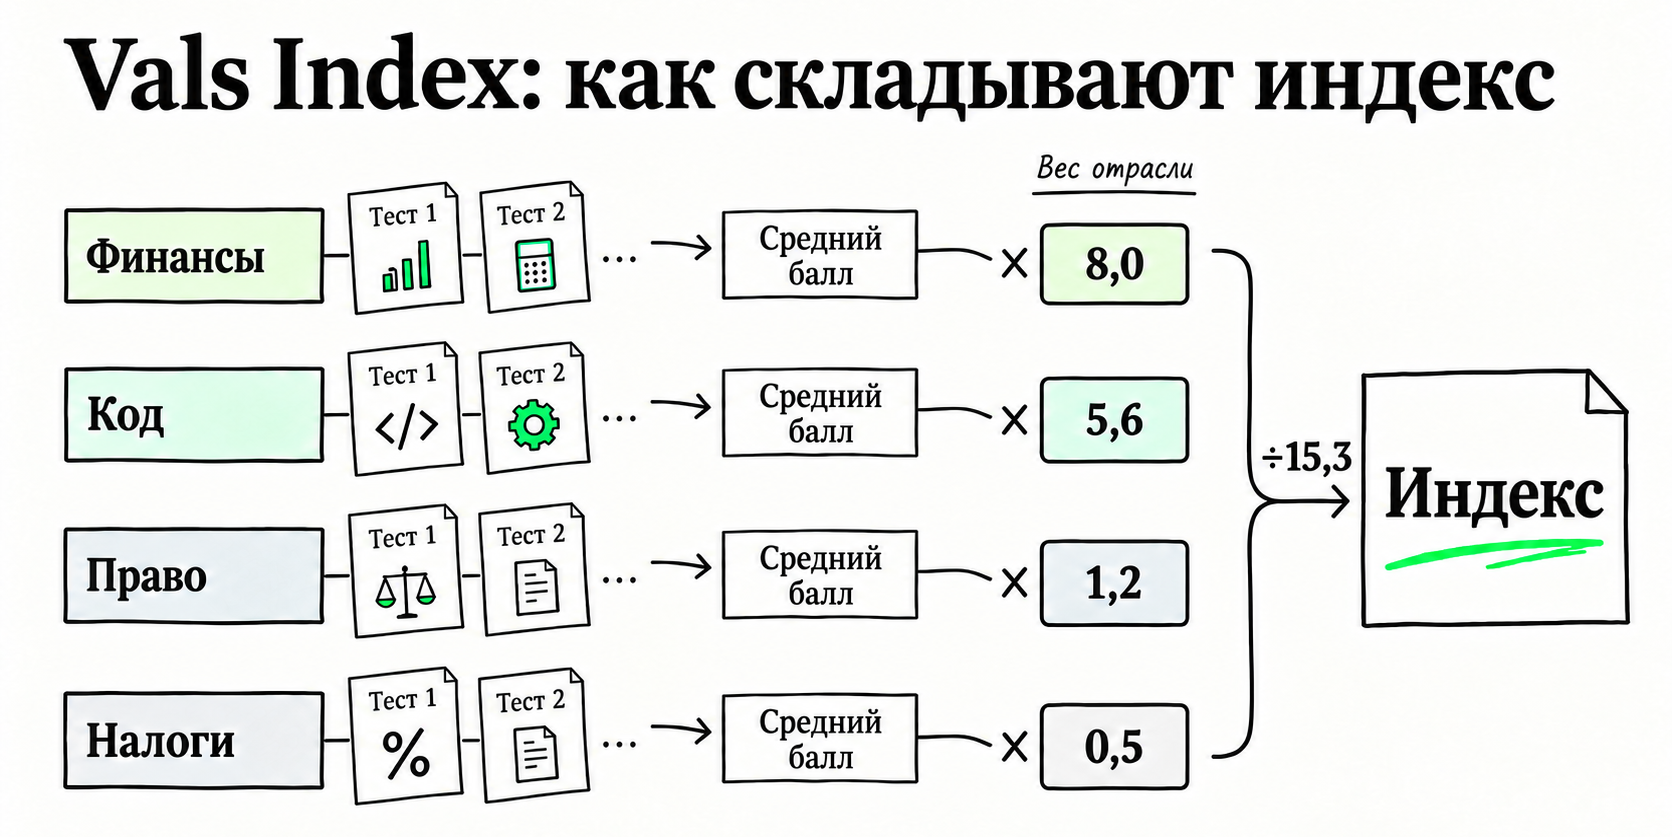
В отличие от предыдущих шести строк, Vals Index — это не отдельный тест со своими задачами, а сводный рейтинг (агрегатор), который объединяет результаты разных бенчмарков по четырём отраслям: финансам, программированию, праву и налогообложению.
Представим, что мы оцениваем кандидата по четырём профильным экзаменам, но при подсчёте общего балла умножаем оценку за каждый предмет на долю этой индустрии в ВВП США.
Как работает подсчёт (верификация на уровне индекса):
Баллы отдельных бенчмарков → среднее по каждой из 4 отраслей → взвешенная сумма по долям экономики США → итоговый индекс
Собственного проверяющего скрипта у индекса нет — каждый входящий в него тест проверяется по своим правилам (в юридическую корзину, например, входит разобранный выше HLAB). А сам индекс считает итоговое число в два шага:
- Шаг 1. Усреднение внутри отраслей. Результаты всех тестов внутри одной сферы (например, нескольких финансовых бенчмарков) усредняются в единый отраслевой балл.
- Шаг 2. Сборка с отраслевыми весами. В версии Vals Index v2.1 отраслевые баллы складываются с весами, пропорциональными размеру секторов американской экономики (общая сумма весов —
15,3): - Финансы: вес
8,0(~52,3% итогового индекса); - Программирование: вес
5,6(~36,6% итогового индекса); - Право: вес
1,2(~7,8% итогового индекса); - Налоги: вес
0,5(~3,3% итогового индекса).
На числах видно, что почти 89% всего индекса определяют финансы и программирование, тогда как на право и налоги вместе приходится около 11%. Если модель совершит рывок в юридических задачах и прибавит там сразу 10 пунктов, общий Vals Index сдвинется меньше чем на 0,8 балла. Зато прибавка всего на 2 пункта в финансовых тестах поднимет общий рейтинг сильнее.
Обратите внимание: для макроэкономического обзора рынка такие веса логичны, но для вашего конкретного продукта они могут быть совершенно бесполезны. Если вы строите сервис для налоговых консультантов или юристов, высокая оценка в сводном индексе за счёт финансовой математики ничего не скажет о качестве модели на ваших задачах.
Вокруг сводных индексов хорошо видны ещё три важных приёма оформления релизных таблиц:
- Смена версии индекса между релизами. В таблице Argon указано 68,9% (что совпадает с архивным Vals Index v2.1, где у Argon 68,90%). В таблице Carbon подписан уже Vals Index v2.2, где обновили состав компонентов: там у Carbon 70,4%, а пересчитанный балл Argon стал 69,2%.
- Отбор соперников для таблицы. В таблице Carbon Google сравнивает свою модель с выбранными конкурентами, но не включает туда Claude Sonnet 5.5. Если открыть полный лидерборд Vals Index на 29 октября, на первой строчке окажется именно Sonnet 5.5 с результатом 70,85%, а Carbon займёт второе место с 70,36%. Первое место среди колонок в пресс-релизе не всегда означает первое место на рынке.
- Скрытая цена балла. Сводный индекс показывает итоговую точность, но умалчивает, сколько времени и токенов модель потратила на размышления. Например, в другом популярном агрегаторе — Intelligence Index от Artificial Analysis (разбор от 30 сентября) — модели Argon и Astra набрали одинаковые 53 балла, но Argon тратила на прохождение в среднем около 62 тыс. выходных токенов против 27 тыс. у Astra (более чем двукратная разница в объёме генерации). В октябрьской таблице Carbon этот индекс тоже обновился до версии v5.0: там у Carbon 59 баллов, а у Argon уже 50 вместо прежних 53.
Альтернатива чужим таблицам: свой бенчмарк из рабочего кода
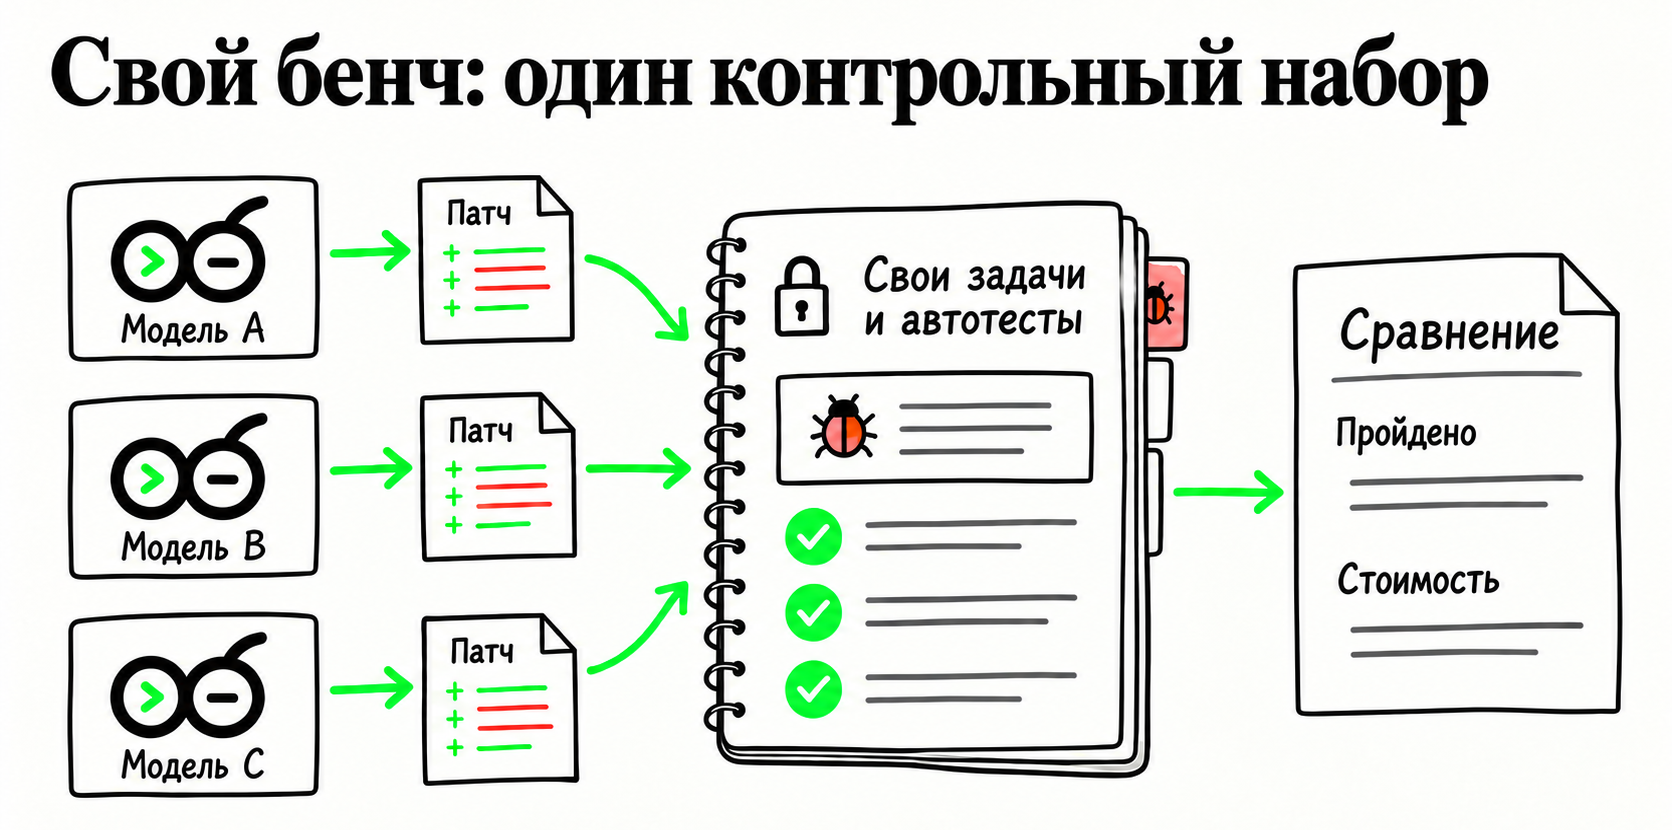
Вместо того чтобы принимать инженерные решения по чужим пресс-релизам, гораздо надёжнее один раз потратить вечер и превратить собственный рабочий код и закрытые задачи в персональный бенчмарк.
Сама идея проста: у любого проекта уже есть готовый полигон — приватный репозиторий, история решённых багов, автотесты и реальные задачи из трекера. Ни одна модель в мире не видела вашу закрытую кодовую базу во время обучения, поэтому списать ответ или выехать на заученном шаблоне здесь невозможно.
Вы один раз собираете такой проверочный стенд, а дальше на каждом громком релизе получаете две практические выгоды:
- Объективная оценка новых моделей за 15 минут. В день выхода условного Gemini 4 Carbon или нового Claude не нужно гадать, насколько честные проценты нарисовали в презентации — достаточно запустить прогон на своих 30 закрытых задачах и посмотреть реальную долю прошедших тестов в вашей архитектуре.
- Оптимизация затрат (cost-effective выбор без потери качества). На практике часто оказывается, что на ваших конкретных пайплайнах быстрая и дешёвая модель за $0,50 на миллион токенов выбивает те же 85% успешных проверок, что и тяжёлый «фронтир» за $15, или решает задачу втрое меньшим числом шагов. Собственный стенд позволяет спокойно переключить продакшен на более дешёвую модель, опираясь на твёрдые цифры, а не на интуицию.
Собирать такую среду вручную с нуля не обязательно — для генерации бенчмарков прямо из своего репозитория уже есть открытые инструменты и простые подходы:
- SWE-smith (от авторов SWE-bench, Stanford / Princeton): открытый инструментарий, который превращает любой GitHub-репозиторий в собственную арену (
SWE-gym). Он поднимает окружение вашего проекта, берёт рабочий код, автоматически генерирует в нём реалистичные поломки (или инвертирует прошлые пул-реквесты и коммиты), отбирает задачи, которые гарантированно ломают один или несколько вашихpytest-тестов, и упаковывает всё в готовый проверочный набор. - R2E (Repository to Environment): фреймворк, который сканирует репозиторий, с помощью статического анализа вырезает нужный срез зависимостей (dependency slicing) и автоматически строит тесты эквивалентности (equivalence test harnesses) вокруг ваших функций. Подходит даже тогда, когда в проекте мало ручных юнит-тестов, но нужно проверить, сможет ли новая модель дописать или оптимизировать метод в вашей кодовой базе, не сломав поведение.
- Метод «Машины времени по собственным PR» (
git reverteval): самый быстрый способ без сторонних библиотек. Скрипт берёт 20–30 ваших реальных закрытых пул-реквестов за последние месяцы, где вместе с кодом фичи или багфикса добавлялся тест. Откатывает сам рабочий код к родительскому коммиту (git checkout <parent_commit>), но оставляет новый тест, а текст вашей задачи из трекера подаёт агенту как промпт.
Заключение
Процент в таблице описывает результат на конкретном бенче и по конкретным правилам проверки — это не универсальная оценка модели.
В GraphWalks и OSWorld за неполный ответ можно получить до 75% баллов. В Terminal-Bench Science оценка зависит от тайм-аута проверяющего скрипта, в LVBench — от частоты выборки кадров, в OSWorld 2.1 — от передачи истории скриншотов. Vals Index учитывает отраслевые веса, а в Intelligence Index одинаковый балл может потребовать более чем вдвое разного числа выходных токенов.
Пользователю не нужно разбираться в каждом проверяющем скрипте. Важно другое: сравнивать модели по бенчу можно, если условия измерения раскрыты и результат воспроизводится. Эту прозрачность должны обеспечивать авторы замера. В следующей статье разберём платформы и организации, которые проводят независимые проверки моделей: что именно они проверяют и по каким правилам сравнивают результаты.
Материалы
- LiveCodeBench: Holistic and Contamination Free Evaluation of LLMs for Code и интерактивный лидерборд LiveCodeBench
- SWE-Lancer: Can Frontier LLMs Earn $1 Million from Real-World Freelance Software Engineering? (OpenAI), лидерборд SWE-bench Pro (Scale AI) и разбор задач SWE-bench Verified от Epoch AI
- Карточка модели Gemini 4 Argon и методология оценки Argon (Google DeepMind)
- Анонс Gemini 4 Carbon, сводная страница моделей Gemini и методология оценки Carbon (Google / DeepMind)
- Репозиторий DeepSWE и разбор проблем верификации DeepSWE от Epoch AI
- Анонс Terminal-Bench Science 0.1 и страница бенчмарка на Vals AI
- Анонс Harvey’s Legal Agent Benchmark, архивный протокол HLAB v1 и обновлённый HLAB-Vals-1.1
- Датасет GraphWalks (OpenAI) и разбор метрики GraphWalks от Epoch AI
- Репозиторий LVBench
- Репозиторий OSWorld-V2
- Vals Index v2.1, актуальный лидерборд Vals Index и разбор Gemini 4 Argon от Artificial Analysis
- Инструменты для сборки собственных бенчмарков из кода: SWE-smith и R2E (Repository to Environment)