Предисловие
В какой-то момент у меня появился доступ к GLM-4.7 и намного больше свободных токенов, чем я успевал тратить в обычной работе. Документацию, Git-рутину и построение графов для ориентации в больших проектах я уже делегировал агентам, поэтому начал искать менее очевидные способы использовать модели. Некоторые из тех экспериментов позже стали постоянными рабочими инструментами. Один из них — два скила для анализа логов.
Сначала я хотел решить довольно приземлённую задачу: дать агенту большой лог и получить не пересказ отдельных ошибок, а понятный отчёт о том, что происходило с проектом.
Запрос «проанализируй лог» выглядит конкретным только до первого действительно большого файла. Дальше агенту приходится сокращать объём данных до того, что он способен обработать. Обычно он начинает с grep по ERROR, WARNING, exception и нескольким очевидным словам. Стратегия рациональная, но у неё есть неприятное свойство: метод отбора строк незаметно становится методом анализа.
В моих проектах лог — не приложение к коду и не место, куда заглядывают только после падения. Это фактическая история жизни системы: что она получила, какие решения приняла, что отфильтровала, где замедлилась и после каких ошибок смогла восстановиться. Подробный отчёт ещё не означает подробного анализа.
Отдельная ERROR-строка тоже почти ничего не доказывает. Ошибка могла быть штатно обработана последующим retry. А реальная проблема может пройти вообще без ERROR: компонент перестал запускаться, счётчик начал постепенно ухудшаться или часть pipeline просто исчезла из логов.
В итоге я разделил анализ на два скила с разной логикой работы:
- Log Validate проверяет лог относительно известных ожиданий, извлечённых из кода.
- Log Insight пытается понять поведение системы по самой последовательности событий — включая проблемы, которые заранее никто не сформулировал.
Log Validate
Первая идея довольно простая: прежде чем искать что-либо в логе, нужно понять, что проект вообще умеет логировать.
Log Validate сначала читает документацию, AGENTS.md или CLAUDE.md и исходный код для понимания контекста всего проекта. Далее находит вызовы логгера и собирает карту сигнатур: модуль, уровень, шаблон сообщения, переменные и смысл события. Статические части сообщений превращаются в точные grep-паттерны, после чего скил проверяет, какие предусмотренные кодом события действительно появились в логе.
Получается дедуктивная схема:
код → ожидаемые сигналы → поиск в логе → проверка покрытия
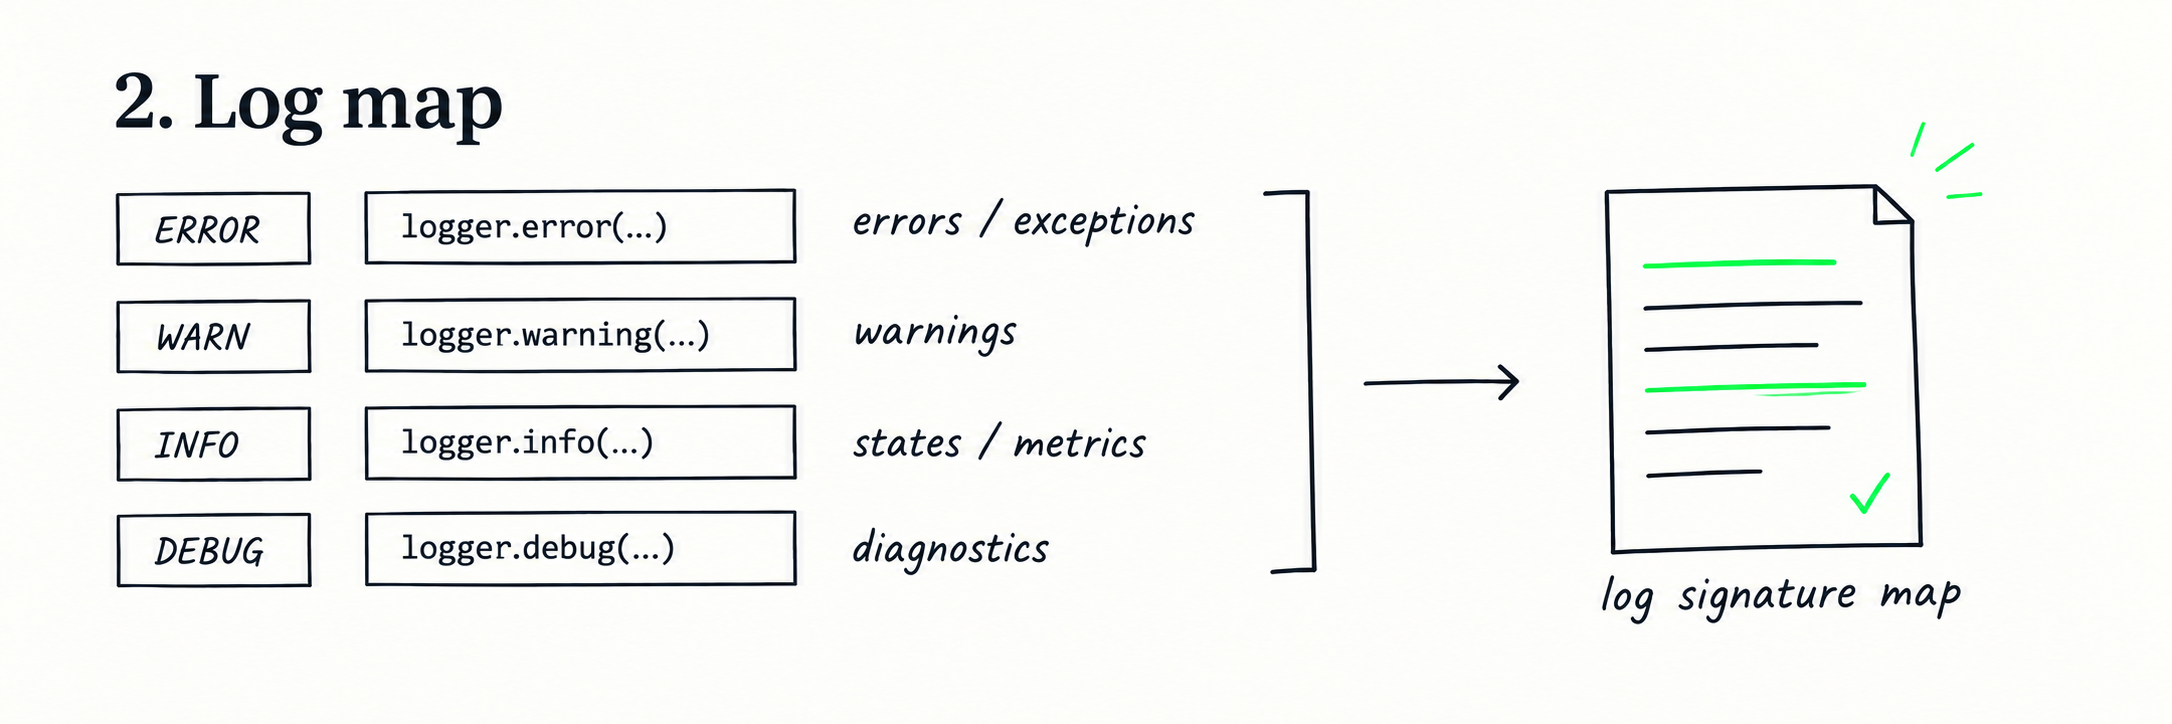
Так можно системно искать не только ошибки и предупреждения, но и метрики, переходы состояний, сигналы запуска и завершения компонентов. При этом нулевое число совпадений становится полноценным результатом. Если в коде у компонента есть несколько лог-сигнатур, а в фактическом запуске не встретилась ни одна, это отдельный повод для проверки: компонент мог не запуститься, выпасть из рабочего маршрута или логироваться иначе, чем предполагает код.
Мне нравится этот подход за контролируемость. Агент не придумывает на ходу, какие строки считать важными: пространство поиска задаёт сам проект. Проверку можно воспроизвести, а standalone-версия опирается на обычные shell-инструменты и не привязана к конкретной агентной платформе. По сравнению с чтением больших непрерывных фрагментов это ещё и сравнительно дешёвый первый проход.
На выходе получается не просто список совпадений, а структурированный отчёт. В нём видно, какие сигнатуры были извлечены из кода, сколько раз они встретились в логе, какие предусмотренные события не появились и какие компоненты остались «молчащими». Для найденных проблем скил добавляет примеры строк, временной диапазон, оценку серьёзности, гипотезу причины, возможное влияние и рекомендацию.
На реальном логе OctoPrint этот проход построил карту 829 вызовов логгера в 263 модулях и показал, какие предусмотренные кодом сигналы действительно проявились; полный отчёт Log Validate.
Но Validate не превращается от этого в полный анализ лога. Он хорошо отвечает на вопрос «проявилось ли то, что мы ожидали увидеть?», однако остаётся привязан к заранее найденным сигнатурам. Если проблема выражается не одной строкой, а последовательностью формально нормальных событий, или вообще не имеет узнаваемой сигнатуры, такой анализ легко её пропустит.
Иными словами, Validate хорошо ищет то, что мы заранее научились искать.
Log Insight
Log Insight появился именно из недоверия к анализу по коротким выборкам.
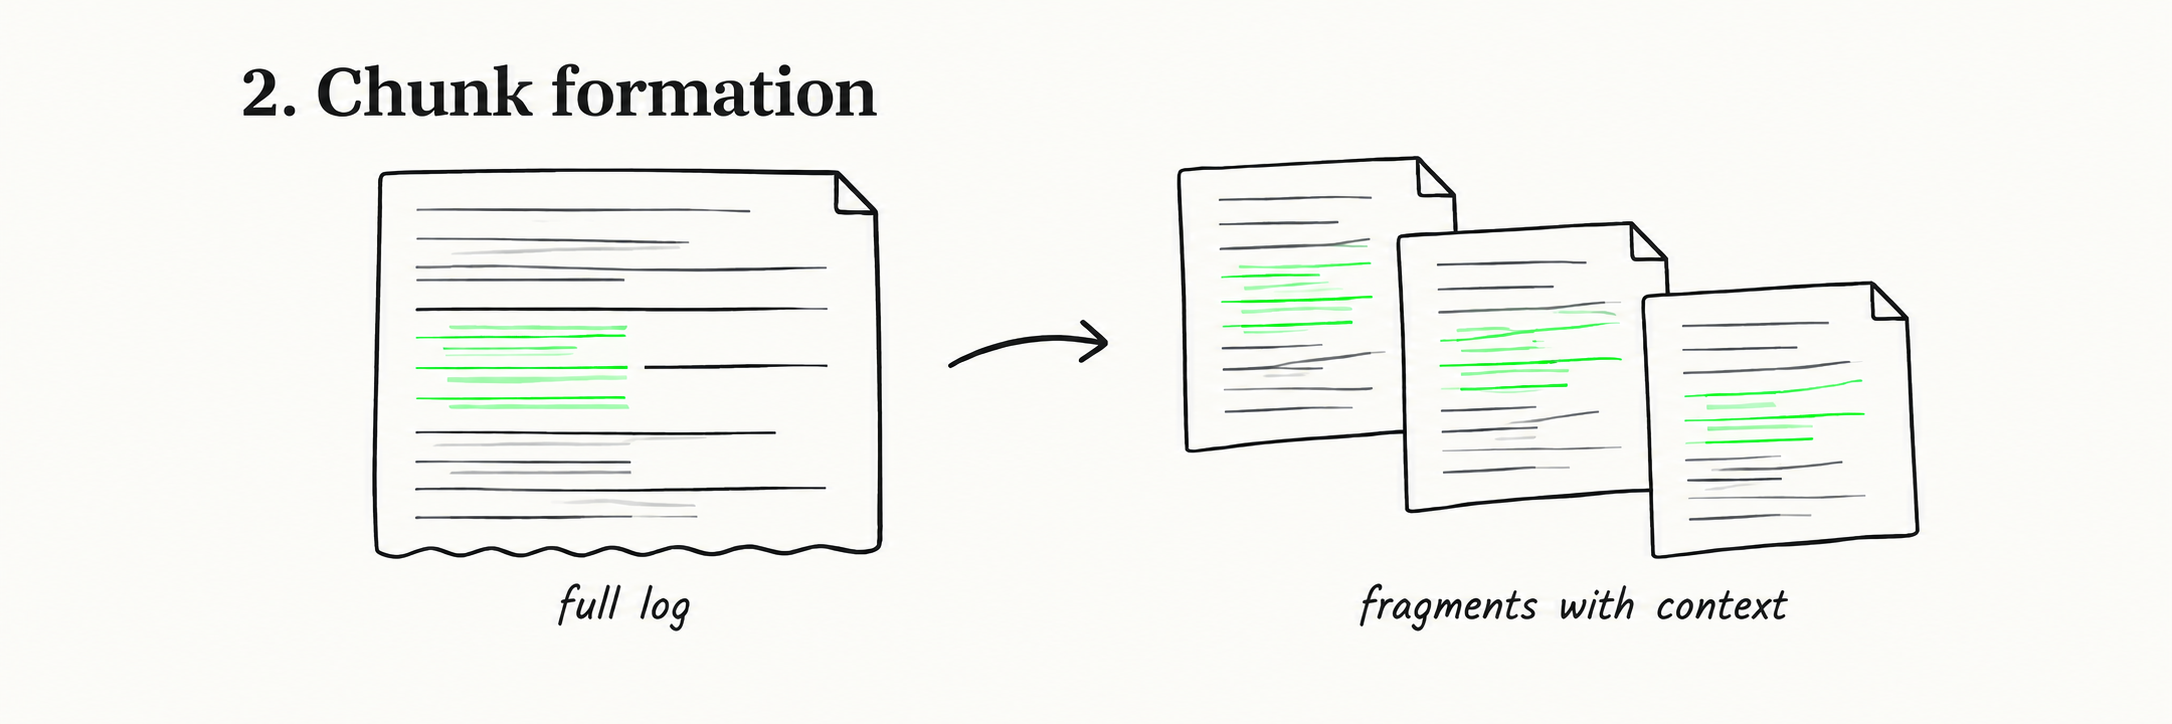
Я хотел, чтобы агент видел не несколько строк вокруг совпадения, а цельный участок жизни системы — настолько большой, насколько позволяет контекст.
Но непрерывный фрагмент без знания проекта тоже мало полезен. Поэтому сначала оркестратор собирает единый контекст проекта из документации, бизнес-правил, workflow и конфигурации. В него входят архитектура, happy path, допустимые ветки ошибок, retry и fallback, инварианты и числовые пороги.
Брифинг задаёт модель нормального поведения: без неё агент легко объявит штатную повторную попытку аварией или, наоборот, не заметит нарушение бизнес-правила.
Контекст проекта — это не просто техническая вводная, а модель нормального поведения системы. Её может задать человек, сама модель или их совместная работа, и от этого выбора частично зависит последующий результат анализа.
После этого лог делится на N хронологических чанков. Каждый субагент получает полный текст одного чанка и тот же контекст проекта. Не grep-выжимку, не первые и последние строки, а весь выделенный фрагмент. Сначала он обязан прочитать данные, и только затем решает, что в них важно.
Здесь поиск строится уже не только вокруг отдельных совпадений. Субагенты анализируют последовательности и причинные цепочки: что произошло до ошибки, была ли попытка восстановления, завершилась ли операция, как менялись частота событий и метрики, исчезали ли компоненты, возникали ли временные разрывы и другие аномалии.
После параллельного анализа оркестратор консолидирует отчёты, убирает дубли и сравнивает сигналы между чанками. Так появляется не просто список событий, а динамика: проблема была единичной, повторялась стабильно, постепенно усиливалась или возникала скачками.
На реальном примере OctoPrint Log Insight связал повторяющийся snapshot flood с последующим истощением потоков, ошибками памяти и блокировками переподключения к принтеру; полный отчёт Log Insight.
У этого подхода есть цена. Он требует нескольких субагентов, расходует больше токенов и сильно зависит от качества контекста проекта.
В Insight агентная оболочка намеренно сведена к минимуму: оркестратор подготавливает брифинг и передаёт субагенту цельный фрагмент лога. Дальше основной вклад делает сама модель — её способность удерживать последовательность, замечать слабые связи и отличать аномалию от штатной ветки.
Поэтому смена модели может менять не только стиль отчёта, но и сам набор найденных проблем и их критичность.
Пример: один лог, два отчёта
На одном и том же логе OctoPrint два скилла построили разные, но не взаимоисключающие картины.
Log Validate прошёл по известным сигнатурам и показал масштаб уже видимых проблем: 69,4% записей пришлись на OctoEverywhere, а основной вывод оказался связан с сетевыми сбоями и ошибками плагинов.
Log Insight, сравнивая хронологические чанки, увидел другую глубину: повторяющийся snapshot flood, затем 46+ ошибок can't start new thread, MemoryError и блокировки переподключения к принтеру.
Сильная сторона Validate — контролируемый и воспроизводимый ответ по заранее известному пространству сигналов; слабая — он может принять самый частый паттерн за главную проблему.
Insight лучше находит неизвестные заранее связи, но сильнее зависит от брифинга, покрытия файла и выбранной модели. В этом смысле выбор модели для Insight — это выбор интерпретационной оптики: разные модели могут по-разному решить, какие события связаны причинно, а какие являются фоном.
Заключение
Validate проверяет ожидания. Insight восстанавливает поведение.
Я использую их именно в таком порядке. Сначала Validate даёт быстрый системный проход по известным сигналам, ошибкам, покрытию и «молчащим» компонентам. Если причина уже понятна, на этом можно остановиться.
Если ответ зависит от последовательности событий, остаются противоречия или нужны связи, которых мы заранее не сформулировали, я подключаю Insight и отдаю агентам непрерывные участки лога.
Скилы не создадут полезные сигналы там, где проект почти ничего не логирует, не исправят устаревшую документацию и не превратят вывод модели в объективную истину.
Их задача скромнее: сделать процедуру анализа прозрачнее — показать, что искали, что действительно прочитали и где заканчивается покрытие.
Главный вывод после работы над обоими скилами для меня такой: агент анализирует не «лог вообще», а тот способ представления лога, который мы ему дали. Если показать модели только grep-выжимку, она будет рассуждать о grep-выжимке — каким бы умным ни был агент и каким бы большим ни было его контекстное окно.